En resumen: Puntos clave para entender el desafío
- El obstáculo oculto: El cuello de botella de la IA ya no es la capacidad de cómputo, sino el movimiento masivo de datos entre nubes, centros de datos y el borde.
- Impacto financiero: Mantener GPUs ociosas por latencia de ingesta y pagar penalizaciones por tarifas de salida (egress fees) erosiona el ROI de las iniciativas de IA.
- Cambio de paradigma: Las arquitecturas modernas exigen pasar de migraciones aisladas a pipelines de datos continuos, automatizados y optimizados para WAN.
- La propuesta: Riverbed Data Express permite orquestar de 5 a 40 TB por hora y hasta 1 PB por día con criptografía post-cuántica y modelo SaaS.
La acelerada adopción de la Inteligencia Artificial en América Latina está transformando radicalmente las prioridades en los centros de datos corporativos. Aunque los titulares suelen concentrarse en la adquisición de poder de cómputo y la selección de algoritmos de vanguardia (modelos de IA), las organizaciones se enfrentan a un desafío silencioso pero determinante: la incapacidad de trasladar volúmenes masivos de información con la velocidad, seguridad y eficiencia que exige el procesamiento moderno.
En este nuevo paradigma, los datos ya no permanecen confinados en silos locales, sino que residen dispersos entre instalaciones on-premise, nubes públicas regionales, arquitecturas multi-cloud y nodos en el borde (edge). Cuando las iniciativas de IA requieren mover conjuntos de datos a gran escala para entrenamiento, ajuste o inferencia, los métodos tradicionales colapsan la operación y amenazan la viabilidad económica de las implementaciones.
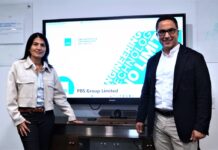
Javier Chistik, Director para América Latina en Riverbed, advierte que concebir la IA como una carga de trabajo convencional es un error de cálculo que paraliza a las empresas: “La IA no es una carga de trabajo tradicional; es una industria hiperactiva de generación y movimiento masivo de datos. Cuando el dato no se mueve a la velocidad que exige el procesamiento, la arquitectura entera sufre parálisis financiera y operativa. Si un clúster de cómputo en la nube o en el data center local debe procesar terabytes o petabytes de datos no estructurados, como videos, imágenes satelitales, telemetría o documentos, la latencia de red y la falta de velocidad en la ingesta hacen que los procesadores tengan que esperar”.
El impacto de este desfase logístico recae con fuerza en el balance contable. Cada hora en la que una costosa unidad de procesamiento gráfico (GPU) permanece en estado de inactividad a la espera de que concluya la transferencia de datos, se traduce en una pérdida directa de capital y en una baja utilización de los activos más valiosos del proyecto. A esto se suman penalizaciones por costos de salida de datos (egress fees) y enlaces WAN transfronterizos saturados que dilatan los ciclos de reentrenamiento.
¿Por qué las redes tradicionales colapsan ante el flujo de datos de la IA?
Las redes convencionales no fueron diseñadas para mover cientos de terabytes de forma continua entre nubes y centros de datos. La distancia física, los protocolos obsoletos y la latencia WAN generan saturación y tiempos de espera prolongados en las GPUs, elevando las tarifas de salida y frenando la rentabilidad de las implementaciones.
Desde la trinchera técnica, la transición hacia esquemas distribuidos expone las limitaciones estructurales de las redes convencionales. Israel Proaño, Sales Engineer de Riverbed LATAM, explica que la industria dejó atrás la era de las migraciones únicas tipo lift & shift para ingresar en una dinámica de flujo continuo e iterativo entre distintas infraestructuras.
Sobre las barreras físicas que experimentan los administradores de infraestructura, Proaño profundiza: “La principal es que las redes convencionales no fueron diseñadas para mover cientos de terabytes o petabytes de forma continua; la distancia, el ancho de banda, el overhead de protocolos y la escala terminan generando grandes ventanas de transferencia y cuellos de botella. Riverbed Data Express nace precisamente para resolver este reto, ofreciendo una plataforma SaaS que orquesta y asegura el movimiento masivo de datos, con velocidades documentadas de 5 a 40 TB por hora por transferencia y hasta 1 PB por día, permitiendo llevar los datos hacia la infraestructura de IA de forma mucho más rápida y simple.”
¿Qué oportunidades de negocio surgen para canales y proveedores MSPs?
El cambio de foco desde la capacidad bruta de almacenamiento hacia la logística activa de la información abre un abanico de servicios gestionados de alto margen. Los canales pueden ofrecer auditorías de salud de pipelines, diseño de arquitecturas WAN optimizadas para la nube y consultoría FinOps para reducir costos por transferencias de datos.
“Para el ecosistema de partners y MSPs, esta transición abre un abanico de servicios gestionados y de consultoría con márgenes significativamente superiores a la reventa tradicional de software: consultoría de evaluación de logística de datos (Data Logistics & Pipeline Health Check), arquitectura y diseño de pipelines inteligentes optimizados para WAN y nube, y servicios gestionados de FinOps orientados a la reducción de costos por transferencia y egress fees”.
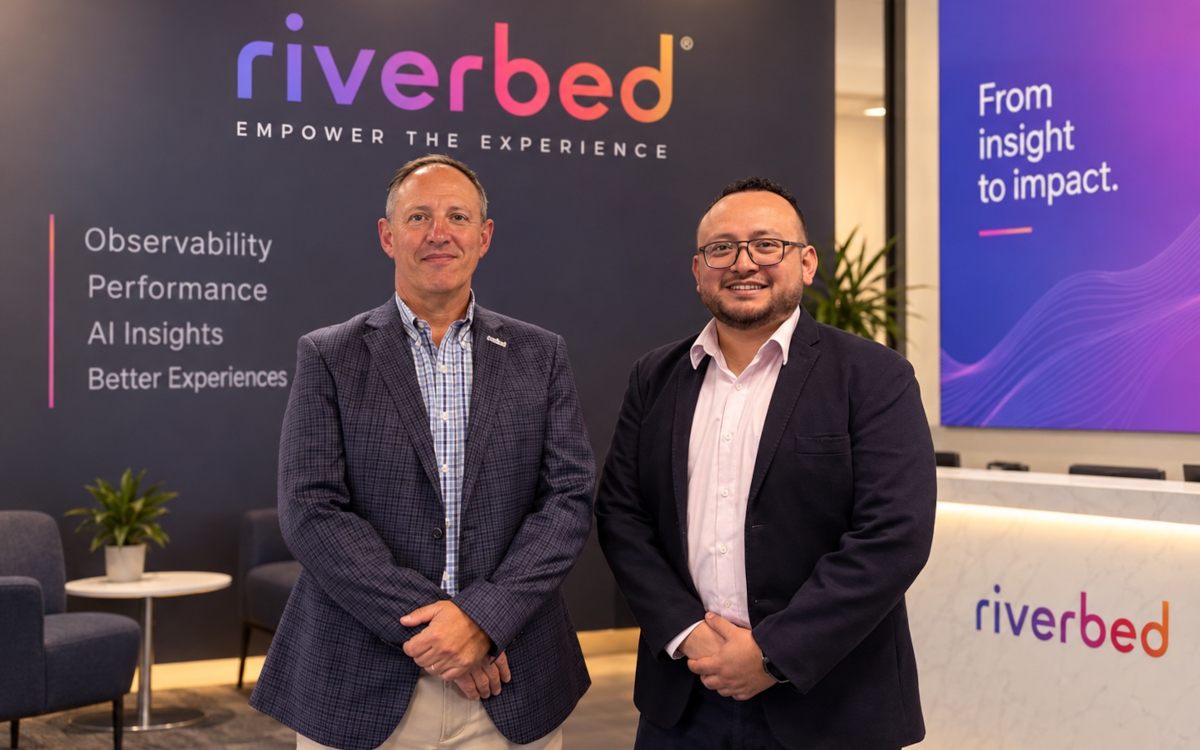
Javier Chistik, Director para América Latina en Riverbed.
Esta transformación en la dinámica de los datos está reconfigurando las prioridades estratégicas de los CIOs de la región. El debate ya no se limita a presupuestar capacidad de almacenamiento en discos SAN o buckets en la nube, sino en garantizar el rendimiento de los pipelines de datos y la monetización en tiempo real. Los tomadores de decisiones buscan socios que puedan sortear las complejidades de la física de redes en ecosistemas heterogéneos.
Para el ecosistema de canales integradores y proveedores de servicios gestionados (MSPs), este cambio de eje representa una oportunidad de negocio sustancialmente más rentable que la reventa tradicional de licencias o hardware.
¿Cómo soluciona Riverbed Data Express la transferencia masiva de datos?
Riverbed Data Express es una solución SaaS diseñada para orquestar y acelerar el transporte masivo de información con escalabilidad concurrente, pago por consumo y cifrado post-cuántico. Su enfoque optimiza la física de red mediante deduplicación y aceleración, reduciendo drásticamente la latencia y hasta un 90% del tráfico transmitido.
En respuesta a estas demandas, la propuesta de Riverbed con Data Express no se limita a acelerar transferencias, sino a incorporar inteligencia, gobernanza y predictibilidad financiera. La solución permite escalar tareas concurrentes bajo un esquema flexible de pago por volumen movido, eliminando fricciones operativas y otorgando visibilidad completa del rendimiento de cada flujo.
Superar este cuello de botella libera capacidades decisivas para el negocio, tales como la implementación de inferencia ultrarrápida mediante arquitecturas RAG (Retrieval-Augmented Generation) sobre fuentes distribuidas, y una verdadera interoperabilidad multi-cloud sin ataduras a proveedores tecnológicos ni costos desmedidos de salida.
En línea con la necesidad de destrabar los proyectos de modernización de las áreas de TI, el Director para América Latina observa que los líderes de esas áreas deberían cambiar el enfoque de la inversión:
“El problema no es la tubería, es la latencia. La recomendación concreta es optimizar la física de la red implementando aceleración y deduplicación para transmitir solo los deltas, lo que puede reducir el tráfico hasta en un 90%, en lugar de limitarse a contratar más ancho de banda. Asimismo, es fundamental medir la logística del dato monitoreando la telemetría del pipeline de extremo a extremo, no solo la salud del almacenamiento o los servidores.”
“Riverbed Data Express aborda este desafío como un servicio SaaS diseñado específicamente para el movimiento masivo de datos: orquesta automáticamente los recursos necesarios y permite escalar las transferencias mediante concurrencia. Además, simplifica la operación con un modelo de pago por datos movidos, incorpora visibilidad sobre throughput y estado de los jobs, y protege la información mediante aislamiento de tenants, SSO/RBAC y túneles seguros con criptografía post-cuántica (PQC). En definitiva, la propuesta es convertir el movimiento de datos de un cuello de botella para la IA en un proceso rápido, escalable, seguro y controlable”.
Israel Proaño, Sales Engineer de Riverbed LATAM.
La movilidad de datos como núcleo de la arquitectura de Inteligencia Artificial
Proaño destaca que, en última instancia, la movilidad de la información debe integrarse formalmente en el diseño de las iniciativas de Inteligencia Artificial desde el día cero: “Cuando resolvemos la movilidad de los datos, aceleramos directamente el valor que podemos obtener de la IA: podemos llevar grandes datasets hacia la infraestructura de cómputo para entrenamiento e inferencia, refrescarlos con mayor frecuencia y habilitar también escenarios como migración a cloud, consolidación de data centers, respaldo y recuperación”.
“Nuestra recomendación es identificar primero dónde está el cuello de botella del movimiento de datos y cuánto está retrasando el proyecto; si mover la información está tomando semanas, necesitamos dejar de verlo como una simple tarea de red y tratarlo como parte de la arquitectura de IA”, destacó el Ingeniero de Ventas.